ycliper

Популярное

Музыка Кино и Анимация Автомобили Животные Спорт Путешествия Игры Юмор

Интересные видео

2025 Сериалы Трейлеры Новости Как сделать Видеоуроки Diy своими руками

Топ запросов

смотреть а4 schoolboy runaway турецкий сериал смотреть мультфильмы эдисон

Видео с ютуба Inference Throughput

Повышение пропускной способности LLM за счет оптимизации вывода данных в масштабе центра обработк...
Повышение пропускной способности LLM за счет оптимизации вывода данных в масштабе центра обработк...

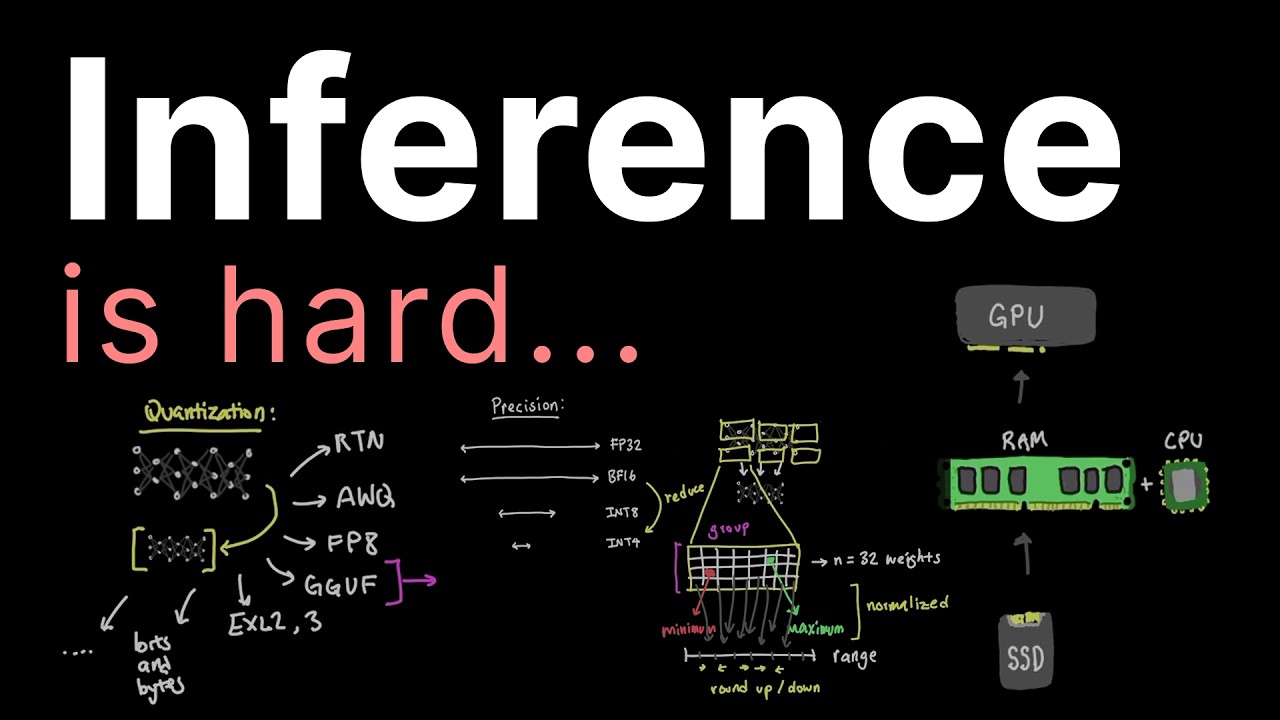
Почему делать логические выводы сложно...

Почему делать логические выводы сложно...

AI Inference: The Secret to AI's Superpowers

AI Inference: The Secret to AI's Superpowers

How KV Cache Speeds Up LLMs for Faster AI Models on GPUs

How KV Cache Speeds Up LLMs for Faster AI Models on GPUs

Throughput vs Latency | System Design
Throughput vs Latency | System Design

Why AI Inference is a Memory Bandwidth Problem

Why AI Inference is a Memory Bandwidth Problem

Together Compiler Delivers 2.6x Inference Throughput

Together Compiler Delivers 2.6x Inference Throughput

Золотой треугольник оптимизации вывода: баланс между задержкой, пропускной способностью и качеством.

Золотой треугольник оптимизации вывода: баланс между задержкой, пропускной способностью и качеством.

Deep Dive: Optimizing LLM inference

Deep Dive: Optimizing LLM inference

Освоение vLLM на практическом примере
Освоение vLLM на практическом примере

Faster LLMs: Accelerate Inference with Speculative Decoding

Faster LLMs: Accelerate Inference with Speculative Decoding

Scaling LLM Batch Inference: Ray Data & vLLM for High Throughput
Scaling LLM Batch Inference: Ray Data & vLLM for High Throughput

Python против Rust для инференса LLM: я протестировал оба варианта (100 запросов)

Python против Rust для инференса LLM: я протестировал оба варианта (100 запросов)

Mastering LLM Inference Optimization From Theory to Cost Effective Deployment: Mark Moyou

Mastering LLM Inference Optimization From Theory to Cost Effective Deployment: Mark Moyou

Why LLM Inference Is Memory-Bound, Not Compute-Bound

Why LLM Inference Is Memory-Bound, Not Compute-Bound

What Is LLM Inference? How AI Models Generate Responses

What Is LLM Inference? How AI Models Generate Responses

GPU Inference Batching Explained: Batch Size, Throughput & Latency | Day 40
GPU Inference Batching Explained: Batch Size, Throughput & Latency | Day 40

LLM Inference Deep Dive: TensortRT-LLM, KV Cache, Prefill vs Decode, TTFT, TPOT | NVIDIA NCP-GENL

LLM Inference Deep Dive: TensortRT-LLM, KV Cache, Prefill vs Decode, TTFT, TPOT | NVIDIA NCP-GENL

How is hardware reshaping LLM design?

How is hardware reshaping LLM design?

High Throughput LLM Inference Part 14

High Throughput LLM Inference Part 14

Следующая страница»

© 2025 ycliper. Все права защищены.


  • Контакты
  • О нас
  • Политика конфиденциальности


Контакты для правообладателей: [email protected]